Índice:
- Quais os riscos de um RAID com hard disks defeituosos?
- Como o RAID funciona e onde a redundância encontra limites
- O que acontece durante uma reconstrução com discos instáveis
- Diferenças entre RAID 0, 1, 5, 6 e 10 na prática
- Quais sinais indicam problemas nos hard disks?
- Quanto tempo e dados podem ser perdidos?
- Quais decisões reduzem o risco em um RAID degradado?
- RAID substitui backup? A resposta é não
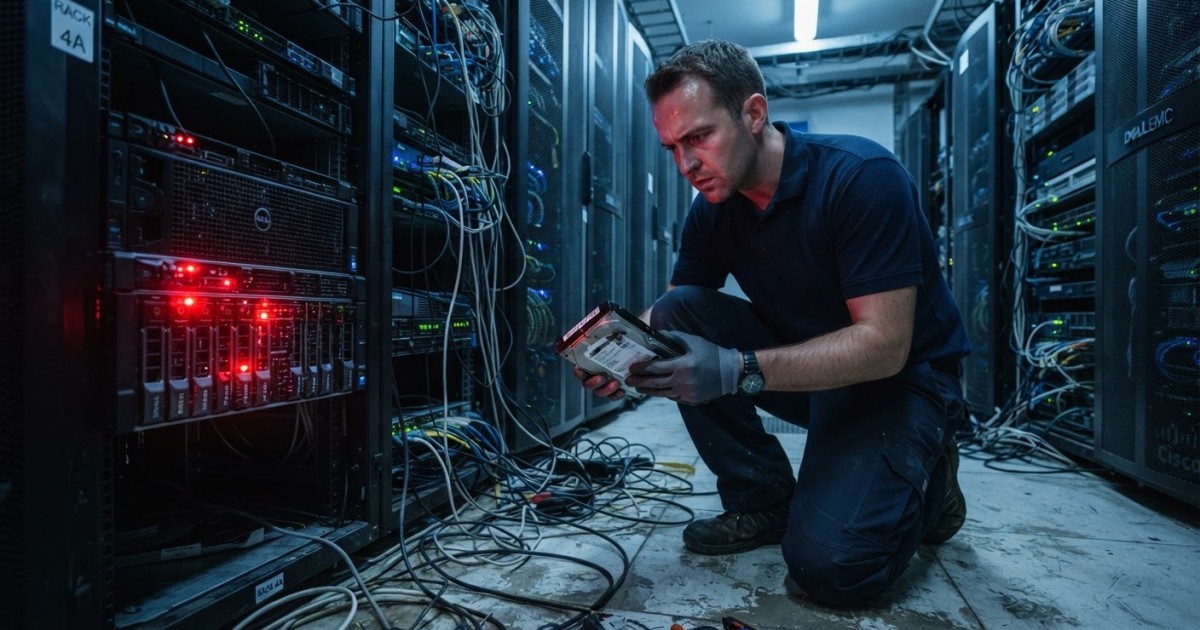
Um servidor pode continuar funcionando mesmo depois que um hard disk apresenta erros. Essa aparente normalidade costuma ser o que atrasa o diagnóstico: o RAID mantém os dados acessíveis, mas opera com menos margem de segurança e pode estar acumulando setores instáveis, falhas de leitura ou problemas no processo de reconstrução.
Os riscos de um RAID com hard disks defeituosos incluem perda de redundância, degradação de desempenho, falha de reconstrução, corrupção silenciosa e, em alguns casos, indisponibilidade ou perda definitiva de dados. Entender esses riscos ajuda a distinguir o que o RAID protege, o que ele não protege e quando a operação deve ser interrompida para uma avaliação técnica.
Quais os riscos de um RAID com hard disks defeituosos?
Um RAID com hard disks defeituosos pode perder a redundância antes que os dados fiquem inacessíveis. Se outro disco falhar durante a reconstrução, se houver setores ilegíveis ou se a controladora não conseguir recompor corretamente as informações, o volume pode ficar degradado, indisponível ou corrompido. A redundância do RAID reduz o impacto de algumas falhas, mas não transforma discos em componentes confiáveis.
O problema costuma começar de maneira discreta. Um disco pode registrar erros corrigíveis, aumentar o tempo de resposta ou apresentar setores pendentes sem falhar completamente. Em um servidor de arquivos, isso aparece como lentidão ao abrir documentos. Em um storage, pode surgir como alertas intermitentes, aumento da latência ou uma unidade que entra e sai do estado de erro.
Enquanto isso, o sistema continua atendendo às aplicações. Essa continuidade é útil, mas também cria uma falsa sensação de segurança. O ambiente pode estar funcionando apoiado em uma única cópia operacional, sem a proteção esperada do conjunto.
Como o RAID funciona e onde a redundância encontra limites
RAID é uma tecnologia que combina dois ou mais discos para distribuir dados, melhorar desempenho, oferecer tolerância a falhas ou equilibrar esses objetivos. Dependendo do nível utilizado, a proteção pode vir de cópias completas, como no RAID 1, ou de informações de paridade, como no RAID 5 e no RAID 6.
A paridade é um cálculo que permite reconstruir dados ausentes quando um disco falha. Ela não é uma cópia integral de cada arquivo. Durante uma reconstrução, o sistema precisa ler grandes quantidades de dados restantes e recalcular as informações que estavam no disco substituído. Se uma dessas leituras encontrar um setor que não pode ser recuperado, a reconstrução pode não terminar corretamente.
Outro limite importante é que o RAID protege principalmente contra determinados tipos de falha física de disco. Ele não impede exclusões acidentais, arquivos sobrescritos, ransomware, corrupção causada por software, incêndio, roubo do equipamento ou erro de configuração. Também não resolve automaticamente falhas da controladora, do backplane, da fonte de alimentação ou do próprio sistema de arquivos.
Por esse motivo, RAID e backup cumprem funções diferentes. RAID busca manter o serviço disponível diante de algumas falhas; backup permite recuperar dados após perda, corrupção ou alteração indevida. Um ambiente pode ter RAID e ainda assim não possuir uma cópia recuperável.
O que acontece durante uma reconstrução com discos instáveis
A reconstrução é o período mais sensível para um conjunto degradado. O novo disco precisa receber os dados reconstruídos, enquanto os discos antigos continuam sendo lidos e, muitas vezes, atendendo às operações normais. Em volumes grandes, esse processo pode levar muitas horas ou mais, dependendo da capacidade, da carga de trabalho, da tecnologia usada e das políticas da controladora.
Durante esse intervalo, a redundância fica reduzida. No RAID 5, uma única falha de disco já coloca o conjunto em estado degradado; uma segunda falha ou um erro irrecuperável de leitura pode comprometer o volume. O RAID 6 suporta a perda simultânea de dois discos por meio de dupla paridade, mas também não elimina riscos de corrupção, falha de hardware compartilhado ou problemas em mais unidades durante a reconstrução.
Há ainda uma diferença entre um disco oficialmente “falho” e um disco que contém setores difíceis de ler. A controladora pode retirar uma unidade do conjunto porque ela demorou demais para responder, mesmo que parte dos dados ainda esteja acessível. Em outras situações, um disco aparentemente saudável pode apresentar setores ilegíveis somente quando é lido em grande escala.
O desempenho também pode cair. Leituras que dependem da paridade exigem mais operações, e a controladora pode limitar a velocidade da reconstrução para evitar que as aplicações fiquem completamente lentas. A decisão de acelerar ou reduzir esse processo envolve um equilíbrio entre tempo de exposição ao risco e impacto no uso do storage.
Diferenças entre RAID 0, 1, 5, 6 e 10 na prática
Os níveis de RAID não oferecem a mesma proteção. A escolha precisa considerar capacidade, desempenho, quantidade de discos, perfil de leitura e escrita, criticidade dos dados e estratégia de recuperação.
| Nível | Como distribui os dados | Comportamento diante de falhas | Uso e atenção necessária |
|---|---|---|---|
| RAID 0 | Divide os dados entre os discos, sem redundância. | A falha de um disco pode inutilizar o conjunto. | Prioriza desempenho e capacidade, mas não deve ser tratado como proteção de dados. |
| RAID 1 | Mantém uma cópia espelhada em outro disco. | Normalmente suporta a falha de um disco do espelho. | Tem recuperação mais simples, mas uma corrupção ou exclusão pode ser replicada para as duas cópias. |
| RAID 5 | Usa distribuição de dados e uma camada de paridade. | Suporta uma falha de disco, dentro das condições previstas. | A reconstrução pode ser demorada e deixa o conjunto mais exposto a uma nova falha. |
| RAID 6 | Usa dados distribuídos e dupla paridade. | Suporta a falha de até dois discos, conforme a implementação. | Oferece margem maior, mas exige mais cálculos e pode sofrer impacto de desempenho na escrita. |
| RAID 10 | Combina espelhamento e distribuição de dados. | Pode suportar falhas em diferentes pares, desde que não sejam os dois discos do mesmo espelho. | Costuma oferecer boa resposta e reconstruções mais diretas, com menor aproveitamento bruto de capacidade. |
Essas descrições representam o comportamento típico, não uma garantia para qualquer configuração. Em um RAID 10, por exemplo, a perda de dois discos pode ser tolerada ou pode derrubar o volume, dependendo dos pares afetados. Já no RAID 1, a existência de duas unidades não significa que as duas estejam saudáveis: um espelho pode permanecer acessível enquanto uma das cópias acumula erros.
Em servidores com muitas transações, a tolerância a falhas precisa ser analisada junto com o tempo de reconstrução. Em storages de grande capacidade, a quantidade de dados a ser lida pode tornar a reconstrução um período longo e exigente. Em ambientes de backup, o RAID ajuda a manter o repositório disponível, mas não substitui cópias independentes, pois um problema lógico ou uma exclusão pode atingir os dados armazenados e suas estruturas de controle.
Quais sinais indicam problemas nos hard disks?
O primeiro sinal nem sempre é uma falha completa. Alertas de SMART, aumento de setores realocados ou pendentes, erros de leitura, comandos que excedem o tempo esperado e mudanças frequentes para o estado degradado merecem investigação. Um disco que desaparece temporariamente do sistema também deve ser tratado como suspeito, mesmo que volte a funcionar depois de uma reinicialização.
Os locais de verificação dependem da arquitetura. Em um servidor, a análise pode envolver o sistema operacional, os registros de eventos e a ferramenta de gerenciamento da controladora. Em um storage, é necessário consultar a interface de administração, os logs do equipamento, o estado dos discos, os grupos RAID e os alertas de temperatura ou conectividade. Em equipamentos com controladora dedicada, o sistema operacional pode não enxergar diretamente todos os erros físicos.
Monitoramento centralizado ajuda a perceber tendências que um alerta isolado não mostra. Um contador de erros que cresce, uma unidade mais lenta que as demais ou uma sequência de alertas em horários de maior carga pode indicar degradação progressiva. Testes de leitura, verificação de consistência e operações de scrubbing, quando disponíveis e compatíveis com o fabricante, também podem revelar problemas antes de uma falha visível.
O diagnóstico deve ser cuidadoso. Retirar um disco saudável por engano pode transformar uma situação controlável em uma falha real. Antes de substituir qualquer unidade, convém confirmar o número físico do slot, o estado apresentado pela controladora, a identificação do disco e a existência de uma cópia atualizada dos dados.
Quanto tempo e dados podem ser perdidos?
Não existe um prazo único para uma reconstrução de RAID. O tempo depende da capacidade dos discos, da velocidade efetiva de leitura e escrita, do nível de RAID, da carga das aplicações, da política da controladora e da ocorrência de erros durante o processo. Um conjunto pequeno e pouco utilizado pode se recuperar relativamente rápido; um storage muito ocupado pode permanecer degradado por muitas horas ou por mais tempo.
A perda de dados também depende do tipo de falha. Se o RAID continuar íntegro e a substituição for concluída, pode não haver perda de arquivos. Se o volume ficar indisponível, a operação pode parar durante o tempo necessário para diagnóstico, troca de componentes, reconstrução e validação. Quando ocorre corrupção, a recuperação pode exigir restauração de backup, e os dados perdidos serão aqueles que não estiverem presentes na cópia mais recente ou em outra versão disponível.
Em uma rotina de backup, essa diferença é especialmente importante. Um repositório em RAID 5 pode ficar acessível mesmo com uma unidade falha, mas isso não informa se os backups são restauráveis. A confirmação exige testes de recuperação, verificação dos catálogos e, quando aplicável, validação de arquivos selecionados. Backup concluído não é sinônimo de backup recuperável.
O objetivo de recuperação da operação também precisa ser conhecido. O RPO representa quanto dado a empresa aceita perder desde a última cópia válida. O RTO representa quanto tempo pode ser necessário para restabelecer o serviço. O RAID pode reduzir o impacto imediato de uma falha, mas não define sozinho nenhum desses objetivos.
Quais decisões reduzem o risco em um RAID degradado?
A primeira decisão é evitar ações impulsivas. Reinicializações repetidas, testes destrutivos, troca de discos sem identificação segura e reconstruções iniciadas sem avaliar a condição do conjunto podem piorar o quadro. O estado atual deve ser registrado, incluindo alertas, discos envolvidos, nível de RAID, capacidade, última cópia válida e alterações recentes.
- Se o volume ainda estiver acessível, reduzir tarefas não essenciais pode diminuir a carga durante a análise e preservar desempenho para operações críticas.
- Se houver erros de leitura em mais de uma unidade, a prioridade deve ser avaliar a cópia dos dados e o risco de reconstruir antes de substituir componentes em sequência.
- Se o problema estiver relacionado à controladora, ao backplane ou à alimentação, trocar apenas o disco não corrige a causa e pode provocar novas interrupções.
- Se os dados forem importantes, a recuperação deve ser planejada antes de tentativas de reparo, especialmente quando existem sinais de corrupção ou falhas simultâneas.
A substituição preventiva de discos também precisa de critério. Um alerta isolado pode exigir observação e confirmação; já a combinação de setores instáveis, erros de leitura e falhas de comunicação indica uma situação mais urgente. O fabricante, a controladora e o ambiente de uso podem estabelecer procedimentos específicos, e eles devem ser considerados antes da intervenção.
Depois da reconstrução, o trabalho não termina. É necessário confirmar se o conjunto voltou ao estado esperado, verificar se persistem erros, validar o sistema de arquivos e revisar os backups. Uma unidade nova pode estar operacional sem que a causa original tenha sido resolvida, e um volume saudável não prova que os arquivos estejam íntegros.
RAID substitui backup? A resposta é não
RAID não substitui backup porque mantém os dados dentro do mesmo conjunto lógico e, normalmente, no mesmo equipamento. Uma exclusão, infecção, erro de aplicação, falha da controladora ou dano físico pode afetar tanto os dados principais quanto a redundância disponível.
Uma estratégia mais segura combina redundância local com cópias independentes, histórico de versões e testes periódicos de restauração. A distância entre as cópias, o controle de acesso e a possibilidade de manter uma versão não acessível por sistemas comprometidos também precisam entrar na análise, conforme a criticidade dos dados.
A pergunta mais útil não é apenas “qual RAID suporta mais falhas?”, mas “como a operação continua e como os dados serão recuperados se o conjunto inteiro deixar de ser confiável?”. Essa mudança de perspectiva evita escolher um nível apenas pela capacidade disponível ou pela promessa de tolerância a falhas.
Em servidores, storages e ambientes de backup, o RAID é uma camada de disponibilidade, não uma garantia de recuperação. Monitorar a saúde dos discos, investigar sinais precoces, planejar a reconstrução e testar cópias recuperáveis reduz o risco de descobrir, no momento da falha, que a redundância não cobria o problema real. Vale guardar esses critérios para revisar a próxima configuração ou analisar um volume que já apresenta alertas.
Não perca mais tempo: fale AGORA com um especialista!
Tire suas dúvidas sobre segurança de dados em minutos e descubra como podemos ajudar você ainda hoje. Atendimento rápido e direto pelo WhatsApp.
QUERO FALAR NO WHATSAPP